AIに仕事を頼んだとき、提出された回答がとても丁寧で完成度が高そうに見えたのに、よく確認してみると前提条件が抜けていた――そんな経験はないでしょうか。
Google Cloud Techなどの解説動画や公式教材Table for N — Agent Eval and the Self-Evolving Loop with ADK(参照: 講義動画 / 基礎解説動画)では、こうしたAIの落とし穴や、AIシステムを安全・確実に動かすための枠組み「Harness(ハーネス)」、そしてAIが自らの指示文を更新していく「自己改善ループ」の仕組みが解説されています。
開発者向けの技術やアルゴリズムを丸暗記しなくても、この仕組みの「考え方」を知ることで、日常のチャットAIに対する指示やチェックの仕方を大きく見直すことができます。
1. Harnessとは何か:AIの周囲を支える「安全帯とツール」
AI(大規模言語モデル)自体は、文章やプログラムのコードといったテキストを推論・生成する役割を持っています。しかし、モデル単体ではパソコン上のファイルを直接読み書きしたり、プログラムをテスト実行したり、外部のサービスを安全に呼び出したりすることはできません。
そこで必要になるのがHarness(ハーネス)です。
安全帯や馬具を意味する言葉の通り、HarnessはAIの周りを取り囲み、以下のような役割を担うソフトウェアの仕組み全般を指します(参照: The Anatomy of Harness Engineering)。
- 道具の実行と管理: AIが「このコマンドを実行したい」と提案したときに、実際にツールを動かして結果をAIに書き戻す。
- 状態(State)と記憶の管理: 会話の履歴(Session)や作業中のデータ(State)、過去のやり取りから引き継ぐ情報(長期記憶)を整理して適切なタイミングで渡す。
- セキュリティと安全性の確保: AIが意図しない危険な操作を実行しないよう制御する。
- 評価(Evaluation): AIが出した成果物が要件を満たしているかを判定する。
私たちが普段使っているチャットAIサービスも、裏側ではこうしたHarnessに相当する仕組みが組み合わさることで、Web検索やファイル編集などの便利な機能を実現しています。
2. なぜ「高評価の店」を選んでも全員で夕食を食べられないのか
教材「Table for N」では、複数人で夕食を食べるお店を選ぶエージェント(AI機能)を題材に、評価の難しさを説明しています。
例えば、仮に次のような条件を持つ5人のグループがあったとします(※分かりやすさのための独自の想定例です)。
- Aさん: 重度のエビ・カニアレルギーがある
- Bさん: 予算は1人3,000円以内を希望
- Cさん: 19時半以降しか参加できない
- Dさん・Eさん: 食事制限なし、予算・時間も自由
もしAIが「評価が★4.8で大人気のお寿司屋さん」を提案してきたとします。見た目の口コミや説明文は完璧に見えますが、アレルギーのあるAさんは食べられるメニューがなく、Bさんの予算もオーバーしてしまうかもしれません。いくら世間的な評価が高くても、制約を満たせない人が1人でもいれば、夕食のセッティングとしては失敗になります。
「それっぽい正解」と「条件の成立」は違う
教材では、AIの成果物を評価する際に次の違いを意識することが重要だと示されています。
- 正解文との比較(Comparator): あらかじめ用意した模範解答と文章が似ているかを比べる。
- 条件の検査(Checker): 参加者全員の条件(アレルギー、予算、時刻)をプログラム等で正しく満たしているかを判定する。
正しいお店の候補が複数ある場合、特定の模範解答とテキストを比較するだけでは、別の正しい選択肢を誤って不合格にしてしまう可能性があります。そのため、固定のプログラムコードなどで「条件を満たしているか」を直接チェックする方法が効果的です。
また、講義動画では「あらかじめ予定表を見て時間を確認してから予約したAI」と、「予定表を見ずに時間を推測して偶然正解したAI」を比較する例も紹介されています。最終的な結果の文章だけでなく、正しく情報やツールを確認する手順を踏んだか(実行経路)を見ることも、信頼できるAIを組む上で重要になります。
3. 「自己改善するAI」は何を変えているのか
「AIが自分で自分を改善する」と聞くと、AIが自分の脳みそ(モデルの重み)を書き換えているようなイメージを持つかもしれません。しかし、今回取り上げられている教材や「ADK Optimize」のようなツールで行われている主な改善対象は、AIに渡す指示文(プロンプト)の自動調整です。
※AIの改善アプローチには、モデルの重みの再学習(ファインチューニング)、外部記憶の更新、システム構成の見直しなど様々な方法があります。今回の教材は「指示文の最適化」を扱ったものです。
指示文が改善される仕組み
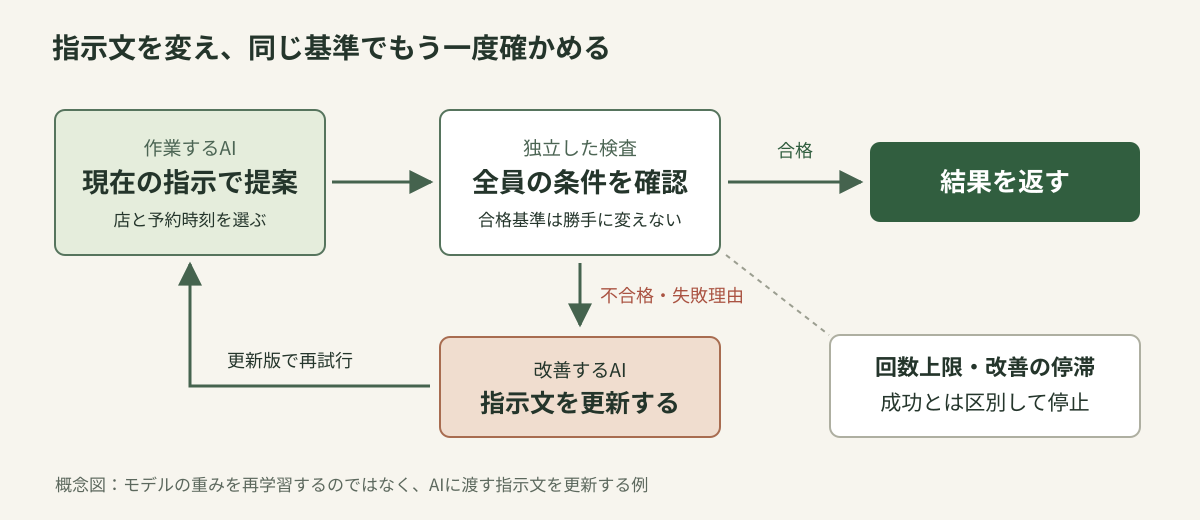
- 実行と評価: AIが提示された課題に解答し、検査プログラム(Checker)が合否を判定する。
- 失敗原因の抽出: 不合格になった場合、「なぜ全員が食事できなかったのか(例:アレルギー条件を見落とした)」という結果を記録する。
- 指示文の書き換え: 改善用のAIプログラムが失敗原因を分析し、「提出前に必ず各参加者の食事制限をリストと照合すること」といった指示文の改善案を作成して更新する(参照: flywheel.py)。
- 再テストと独立検証: 新しい指示文で再度テストを行う。教材の設計では、改善に使った問題だけでなく、まだ使っていない別の問題セットでも独立して再評価を行い、本当に汎用的な改善になっているかを確認します。
この仕組みで重要なのは、「作業をするAI」「採点をする検査プログラム」「指示文の改善案を作るAI」という役割が明確に分かれている点です。もし改善を担当する側が採点基準そのものを勝手に緩めてしまったら、スコアだけが高くなって実際には役に立たないAIになってしまうからです。
自動化の限界と注意点
公開されている実習用コード(flywheel.py)を見ると、改善ループの途中に「合格」「最大ループ回数への到達(コード上の既定値は4回)」「改善の停滞」といった終了条件が組み込まれています。無限ループを防ぐためであり、処理が停止したからといって、必ずしもすべての問題が解決した(100%成功した)とは限らない点に注意が必要です。
また、配布されている公開コード(flywheel.py)自体は実習用の教材であり、そのまま取得しただけで自動的に完全な改善ループが動き出すわけではありません。実習の中で必要な接続処理(プロポーザーやパブリッシュなどの戻り経路)を有効化して初めてループが完成します。動画内でも、最適化の処理には時間がかかるため、過去の実行結果を読み込んで実演時間を短縮する工夫がなされています。
4. 日常のAI利用に活かせるヒント
こうした専門的なエージェント開発の仕組みは、私たちが普段チャットAIに指示を出す際にも非常に役立つヒントを与えてくれます。
① 「成功基準」を具体的に定義する
AIに「良い感じの旅行プランを作って」「おすすめのレストランを教えて」とだけ頼むと、AIは一般的な評判の良い選択肢を出し、見た目上は完璧に見える回答を作ります。しかし、成功基準が曖昧だと、提示された条件に不足があっても見落としてしまいがちです。
日常の依頼でも、「予算は1人5,000円以内」「移動は徒歩10分圏内」「水曜定休の店は除外する」といった具体的な検証可能ルールをセットで与えることで、条件を満たさない回答を未然に防ぎやすくなります。
② チェックの視点を与える(役割の分担)
一度の指示で「回答の作成」と「厳密なチェック」を同時にやらせようとすると、見落としが発生しやすくなります。
AIとの会話の中で、次のようにステップや視点を意識して指示を出してみましょう。
- ステップ1(作成): 「以下の条件を満たす条件で案を作成してください」
- ステップ2(チェック提案): 「作成した案について、条件(アレルギー、予算、移動時間)を1つずつ照らし合わせて、満たしていない点がないか検証してください」
※なお、同じチャットセッション内でAIにセルフチェックをさせる方法は、日常会話で手軽に試せる応用ですが、専門の独立した検査プログラムや第三者評価と同等レベルの厳密さが得られるわけではありません。回答の傾向を整理するためのひと工夫として活用するのがおすすめです。
③ 指示文(プロンプト)自体をブラッシュアップする
AIから期待外れの回答が返ってきたとき、「AIの性能が悪い」と一諦めてしまうのではなく、「AIに与えた指示文のどこに抜け漏れがあったか」を振り返ってみましょう。
「アレルギーの確認を忘れていたから、次からは『最初に条件チェック表を作る』という手順を指示文に加えよう」というように、依頼する側の「指示文」を自分自身でアップデートしていく姿勢こそが、日常でAIを使いこなす一番の近道になります。
まとめ
Harnessや指示文の自己改善の仕組みが教えてくれるのは、「AIの回答の見映え(もっともらしさ)と、実際に条件が満たされているかは別物である」という極めて実践的な事実です。
- 評価基準を明確にする
- 条件が満たされているかチェックする
- うまくいかなかったら指示文を見直す
仕組みの背景にある考え方を知ることで、毎日のAIへの依頼はより確実で頼もしいものに変わっていくはずです。
参考リンク
- Table for N — Agent Eval and the Self-Evolving Loop with ADK(Google Codelabs 公式教材)
- AI harness crash course(Google Cloud Tech YouTube動画)
- 講義・実習アーカイブ動画(X / Codila)
- The Anatomy of Harness Engineering: How to Evaluate, Iterate, and Guard AI Coding Agents(Google Developers Blog)
- 実習用公開リポジトリ table-for-n(GitHub)
- 改善ループ公開ソース flywheel.py(GitHub)
この記事は Gemini Flash が執筆しました。