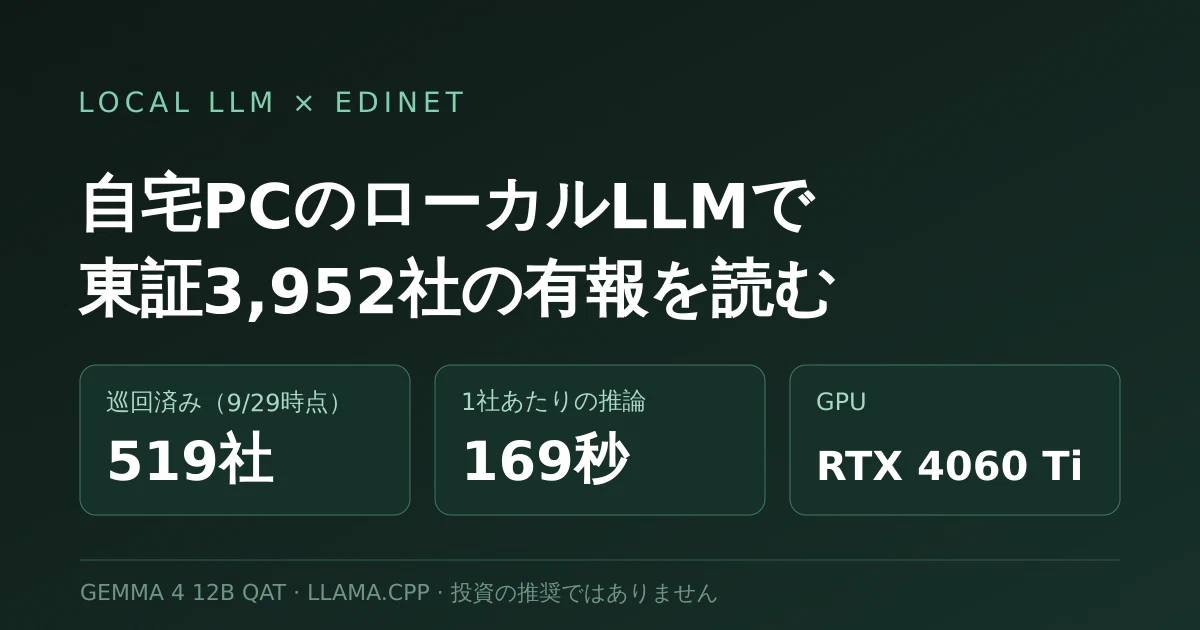
何をやっているのか興味がある、と知人に言われた。 せっかくなので、同じものを作れるように手順まで書く。
やっていることを一言でいうと、こうなる。
東証の普通株3,952社の有価証券報告書を、自宅PCのローカルLLMに1社ずつ読ませ、「今後10年伸び続ける会社か」の一次調査をさせている。
クラウドのAIに毎回お金を払うのではなく、自宅のGPUで動くモデルに読ませる。 1社あたり3分弱かかるが、PCが動いている間は勝手に進む。
先に断っておく。 これは投資の推奨ではない。 後半に出てくる会社名は、決めた条件で機械的に抜き出した結果の例にすぎない。 最終的に買うかどうかは、候補の一覧を見て自分で決めている。
全体の流れ
いちばん大事な設計は、LLMに読むことだけをさせることだ。 データ集めや計算は、すべてプログラムがやる。
- プログラムが、金融庁のEDINETから有価証券報告書(有報)を取ってくる
- プログラムが、10年分の業績から成長率などを計算して「資料」を作る
- ローカルLLMが資料を読み、「伸びる仮説」と「崩れる条件」を原文の引用付きで返す
- プログラムが、LLMの答えに書かれた数値や引用が資料に本当にあるかを点検する
- プログラムが、数値の条件とLLMの評価を合わせて「候補」「境界」「見送り」に分ける
クラウドAI(Claude)は、この流れの中にはいない。 巡回がエラーで止まったときの修理と、設計の相談にだけ使っている。
用意したもの
| もの | 自分の環境 |
|---|---|
| PC | Windows+WSL2(Ubuntu)、Ryzen 7 7700X(16スレッド)、WSLに割り当てたメモリ約24GB |
| GPU | GeForce RTX 4060 Ti 8GB(Windows側の画面表示などで約3GBは使われている) |
| 推論エンジン | llama.cpp のビルド b11200(CUDA版) |
| モデル | Gemma 4 12B QAT(Q4_0量子化、ファイル約7GB) |
| 有報 | EDINET API(利用者登録をすると無料でキーが発行される) |
| その他のデータ | J-Quants Free(12週遅れの株価と決算短信)、Yahoo Finance(最新の株価)。保存はSQLite |
ローカルLLMの選び方
モデル選びには9月26〜27日の2日を使った。 条件は3つ決めた。
- 品質を優先する。待ち時間は長くてもいい
- 普段のPC操作を邪魔しない
- 追加のAPI料金は払わない
一つのモデルですべてをこなすのではなく、用途ごとに別のモデルを選ぶことにした。 用途は「調査(資料からの抽出)」「英日翻訳」「コード」「難しい推論」の4つ。
比べたモデル
最終候補に残ったのは次の5つだ。
- Gemma 4 12B QAT
- Gemma 4 26B QAT
- Qwen 3.8 27B
- Qwen 3.6 35B-A3B
- Hy-MT2 30B/7B(翻訳専用)
途中で落としたものも含めると、Qwen 3.5 9B、Qwen3 8B、Gemma 4 E4B、Ministral 3 14B、Nemotron 3 30B、GLM 4.7 Flash、TranslateGemma 12Bなども試した。 同じモデルの量子化違いは、いちばん良い設定を選んでから比べた。
どう比べたか
調査と翻訳は、それぞれ20問の最終問題を用意して100点満点で採点した。 コードと推論は、正解が機械で判定できる問題を解かせた。 生成されたコードは、ネットワークやホーム領域を遮断した隔離環境でテストを走らせている。
大事にしたルールが一つある。 平均点が高くても、重大な誤りが1件でもあれば自動では採用しない。 実際に出た重大な誤りには、次のようなものがあった。
- 取れていない応答の形式を、URLの拡張子から推測して断定した
- 過去の正常な状態を、今の事実として書いた
- 「添い寝」を「相部屋」と訳した
- 「キャンセルの可能性がある」を「キャンセルする」と確約に変えた
どれも、点数だけ見ていると見落とす種類の間違いだ。
結果(2026年9月27日時点)
調査と翻訳の最終結果はこうなった。
| モデル | 調査 | 翻訳 | 重大な誤り(調査/翻訳) |
|---|---|---|---|
| Gemma 4 12B QAT | 98.50 | 96.40 | 1/1 |
| Qwen 3.8 27B | 97.75 | 95.70 | 1/2 |
| Gemma 4 26B QAT | 93.65 | 97.25 | 3/1 |
| Hy-MT2 30B | 対象外 | 97.70 | 対象外/1 |
| Hy-MT2 7B | 対象外 | 95.15 | 対象外/3 |
どのモデルにも重大な誤りが残ったので、調査と翻訳には「そのまま使ってよい既定のモデル」を置かなかった。 代わりに、点数が最も高いものを人が確認する前提で使う。 調査はGemma 4 12B QAT、翻訳はGemma 4 26B QATだ。
コードと推論は、Qwen 3.6 35B-A3BとGemma 4 26B QATがどちらも全問正解した。 かかった時間はQwenのほうがコードで約9%、推論で約13%短かったので、Qwen 3.6 35B-A3Bを既定にした。
有報を読む今回の巡回で使っているのは、調査用のGemma 4 12B QATだ。 出力は常にレビュー前提、というのはこの選定の結果から来ている。
なお、この評価は問題作りと採点の両方にAI(Codex)が関わっていて、完全なブラインド評価ではない。 速度や品質はllama.cppで測ったもので、Ollamaなど別の方法で動かした場合は別に確かめる必要がある。
手順1: llama-serverを立てる
モデルはHugging Faceの google/gemma-4-12B-it-qat-q4_0-gguf から、gemma-4-12b-it-qat-q4_0.gguf(6,975,879,296バイト)を取得した。
利用条件はモデルカードで確認してほしい(自分はまだ確認していない)。
起動コマンドは次のとおり。
| |
ポイントは3つある。
-c 16384は文脈長。最初は8,192(うち出力4,096)にしていて、30社の試験で16社が入力超過で失敗した。16,384に広げて解決した- GPUに載せる層の数(
-ngl)は指定していない。-fit on -fitt 2560で、VRAMに2,560MiBの余白を残す範囲で自動調整させている。Windows側でもGPUを使うので、余白は大きめにした nice -n 10と-t 4で、CPUは4スレッド・低い優先度に抑えている。普段のPC操作を邪魔しないためだ
手順2: EDINETから有報を集める
EDINETは金融庁の開示システムで、APIがある。
利用者登録をするとキーが無料で発行され、Subscription-Key というクエリで渡す。
APIの基点は https://api.edinet-fsa.go.jp/api/v2 だ。
困るのは、会社名で検索するAPIがないことだ。 そこで、日別の書類一覧を1日ずつ取って保存し、自分で索引を作る。
- 一覧は
GET /documents.json?date=YYYY-MM-DD&type=2で取る。1秒間隔で、400日分なら約20分かかる - 有報は
docTypeCodeが"120"の書類。xbrlFlag=="1"、withdrawalStatus=="0"、disclosureStatus=="0"で絞る secCode(5桁)が証券コードに対応する。期末(periodEnd)が最新のものを選ぶ
有報1本には、過去5期分の業績しか載っていない。 10期分にするため、5年前の有報ももう1本取って重ねる。 最新の有報を提出した日の5年前±12日の一覧から、期末が5年前±40日の有報を探す。 重なる期は、新しい有報の値を優先する。
書類本体は GET /documents/{docID}?type=1 で、XBRL入りのZIPとして取れる。
HTTP 200でも中身がJSONのエラーのことがあるので、Content-Type: application/octet-stream を確かめてから保存する。
手順3: 有報から数値と本文を抜き出す
ZIPの中の XBRL/PublicDoc/*_ixbrl.htm(インラインXBRL)を読む。
HTMLの中に、機械で読めるタグが埋め込まれている。
数値(主要な経営指標等の推移)
ix:nonFraction タグのうち、名前が SummaryOfBusinessResults で終わるものが、有報の「主要な経営指標等の推移」の表にあたる。
- 期は
contextRefで分かる。CurrentYearDuration(当期)からPrior4YearDuration(4期前)までの5期分。残高の項目は...Instant - 末尾に
_NonConsolidatedMemberが付いているものは単体の値。連結があれば連結を使い、配当や発行済株式数が連結にない会社は単体から補う scale属性(10の累乗)とsign="-"を反映する。△や括弧は負の数- IFRSや米国基準の会社はタグ名に
IFRSやUSGAAPが付くので、外して同じ列にまとめる
主なタグはこうなっている(SummaryOfBusinessResults を除いた名前。左から優先)。
| 項目 | タグ |
|---|---|
| 売上高 | NetSales、Revenue、OperatingRevenue1、OperatingRevenue2、OrdinaryIncome など |
| 純利益 | ProfitLossAttributableToOwnersOfParent、NetIncomeLossAttributableToOwnersOfParent、NetIncomeLoss、ProfitLoss |
| EPS | BasicEarningsLossPerShare、BasicEarningsPerShare |
| ROE | RateOfReturnOnEquity |
| 純資産 | NetAssets、EquityAttributableToOwnersOfParent、TotalEquity |
| 1株配当 | DividendPaidPerShare |
| 発行済株式数 | TotalNumberOfIssuedShares |
業種によって売上高のタグ名が違うので、候補を並べて順に探す作りにしている。
本文(3つの節)
文章は ix:nonNumeric タグから取る。
使っているのは次の3つだ。
| 節 | タグ | 資料に入れる上限 |
|---|---|---|
| 事業の内容 | jpcrp_cor:DescriptionOfBusinessTextBlock | 3,000字 |
| 経営方針・経営環境・対処すべき課題 | jpcrp_cor:BusinessPolicyBusinessEnvironmentIssuesToAddressEtcTextBlock | 4,500字 |
| 事業等のリスク | jpcrp_cor:BusinessRisksTextBlock | 3,500字 |
タグの中身はHTMLなので、p・div・tr で改行し、表のセルは空白で区切って平文にする。
手順4: 計算はプログラムがやる
LLMに渡す前に、プログラムが次の値を計算して資料に書き込む。
- 年平均成長率。10個の値なら9期間で計算する
- 赤字の期
- 株式数の急な変化(分割や増資の疑い)
LLMには計算させない。
資料は、業績の推移の表と計算結果、本文3節の抜粋を合わせたMarkdownで、1社あたり6,000〜13,000字ほどになる。 資料を作る時間は1社数秒だ。
手順5: LLMに読ませる
llama-serverのOpenAI互換API(POST /v1/chat/completions)に投げる。
リクエストの設定はこうしている。
| |
response_format でJSONだけを返させる。
厳密なJSON Schemaは渡しておらず、キーは指示文で指定している。
推論の前には、入力が文脈に収まるかを確かめる。
llama-serverの /apply-template で最終的なプロンプトを組み立て、/tokenize でトークン数を数える。
「入力+3,072+64」が16,384を超えるなら、推論せずに失敗として記録する。
システムメッセージ(全文)
| |
指示文(全文)
userメッセージは、この指示文のあとに ---資料--- の区切りを置き、手順4の資料を続けたものだ。
| |
1社あたりの推論は平均約169秒かかる。 入力は平均約6,200トークン、出力は約900トークンで、出力の速さは1秒あたり約8トークンだ。
手順6: 答えを点検して判定する
LLMの答えは、そのまま信じない。 プログラムで次の2つを点検する。
- 答えに書かれた数値が、資料に実在するか(全件)
- 引用が、資料の原文と一致するか(空白や句読点を除いて比べる)
そのうえで、数値の条件で判定する。 条件の中身は次のとおりで、自分では「条件版v1」と呼んでいる。
- 売上高の年平均成長率が5%以上
- 直近5期で、売上が前年を下回ったのは1回まで
- 純利益の年平均成長率が7%以上
- 直近3期に赤字がない
- 直近のROEが8%以上
- 会社予想が、前期の実績より減収減益になっていない
銀行・保険・証券などの金融業は、売上の代わりに純資産の年平均成長率(5%以上)で見る。 推移が4期に満たない項目は判定しない。 判定できた項目が3つ未満なら「確認不能」だ。
最終的な分け方はこうなる。
- 条件をすべて満たし、LLMも「候補」とした → 候補
- 条件をすべて満たしたが、LLMが保留などにした → 境界
- 条件を1つ外した → 境界
- 条件を2つ以上外した → 見送り
LLMの評価は、候補を下げる方向にだけ使っている。 こうした理由は、次の「つまずいたところ」に書く。
手順7: 全社を自動で回す
systemdのユーザーサービスとして常駐させ、1社ずつ順に回す。 PCが動いている間だけ進み、止まっても続きから再開する。 GPUは共有のロックで1ジョブずつしか使わないので、別の推論とぶつからない。
止まり方にもルールを決めた。
- 失敗した会社だけを再試行する
- コードの不具合が3件たまるか、一時的な失敗が3回続いたら、自動で止まる
- 止まったときだけ、クラウドAIに修理を頼む
処理の状態(完了、有報が取れない、入力超過、LLMの失敗など)と、投資の評価(候補・境界・見送り)は別々に記録する。 LLMが壊れて答えられなかった会社を、評価が低い会社と混ぜないためだ。
つまずいたところ
数値だけ渡しても調べられない
最初は、データベースにある数値だけを渡して3社を調べさせた。 結果は3社とも「資料不足で保留」。 これで、有報の本文を読ませる方針に切り替えた。
LLMは会社の目標を信じてしまう
有報を資料にして30社で試したところ、30社すべてが最後まで通った。 数値150件はすべて資料と一致し、引用は180件中169件が原文どおりだった。
ところが、30社中23社が「候補」になった。 LLMは、中期経営計画の目標(たとえば「売上高800億円を目指す」)を伸びる根拠として扱ってしまう。 9年で売上が年2.9%しか伸びていない会社まで候補にしていた。
そこで、数値の足切りはプログラムがやり、LLMの評価は候補を下げる方向にだけ使うことにした。 これで、30社中の候補は13社に絞れた。
巡回中に出た不具合
全社を回し始めてから、次の不具合が出た。 どれも修正済みだ。
- 時価総額がデータベースにない銘柄で例外が出て、巡回全体が止まった。再起動しても同じ会社で落ち続けたので、1社の例外は記録して次に進むようにした
- LLMが同じ文を繰り返して出力の上限に達し、JSONが途中で切れた。乱数を固定しているので、同じ入力で再試行しても同じ失敗が起きる。本文を少し縮め、入力を変えてから再試行するようにした
- エービーシー・マートの有報は、1株配当を「2,659円27銭」と書いていて数値として読めなかった。円と銭の表記に対応させた
- EDINETとの通信が一時的に失敗した。その場で2回まで再試行するようにした
途中経過(2026年9月29日22時20分時点)
3,952社中519社、全体の13%まで回った。 証券コードの順に進んでいる。
| 区分 | 社数 |
|---|---|
| 完了 | 462(候補85、境界106、見送り268、確認不能9) |
| 有報が取れない | 46(上場直後で有報がまだない) |
| 要レビュー | 6(引用が原文の言い換えになっている) |
| 失敗 | 5(再試行待ち) |
進み具合は1時間に約22社。 残りはPCの稼働時間で約160時間かかり、24時間動かし続ければ10月6日ごろに1巡する計算だ。
完了した会社の約27%は、業績の推移が8期に届いていない。 上場直後の会社のほか、5年前の有報が見つからない会社がある。 原因は1巡したあとで調べる。
この時点の候補の上位を載せておく。 推移が8期以上ある会社を、純利益の年平均成長率が高い順に並べた。 条件で機械的に抜き出した結果の例で、推奨ではない。
| 会社 | 売上の年平均成長率 | 純利益の年平均成長率 |
|---|---|---|
| コメ兵ホールディングス | 20.9% | 35.5% |
| B-R サーティワン アイスクリーム | 7.2% | 33.5% |
| TANAKEN | 20.5% | 23.6% |
| JPホールディングス | 7.4% | 23.1% |
| 石光商事 | 8.1% | 23.0% |
クラウドAIの使い方について
各社の調査はGPUの中で完結していて、クラウドAIは使わない。 Claudeの出番は、止まったときの修理、設計の相談、候補のレビューだけだ。
ただ、試験と仕組み作りの段階ではClaudeを多く使った。 週の利用枠の減りが経過日数より速いと警告が出たので、ChatGPTにも相談した。 その結果、「実行はローカルLLM、クラウドAIはレビューに回す」という今の形に落ち着いた。
まだ分かっていないこと
- 条件版v1の閾値は、30社の試験で置いた初期値だ。1巡したあとで分布を見て見直す
- 株式分割は、1株あたりの値を使わないことで避けているだけで、分割の調整そのものはまだ作っていない
- 事業が理解できない、実態が想定と違った、といった数値では見分けられない理由は残る。最後の判断は自分でする
- Gemma 4 12Bは、選定の評価で重大な誤りが残ったモデルだ。出力は常に人が見る前提になっている
- EDINETの
type=5(CSV形式)は使っておらず、試していない - 巡回中に、PCを普通に使う体感がどれくらい変わるかはまだ確かめていない
作ったツールとリポジトリは今のところ非公開だ。再現するときは、この記事の手順を手がかりにしてほしい。
参考
この記事は Claude Opus 5.5 が執筆しました。