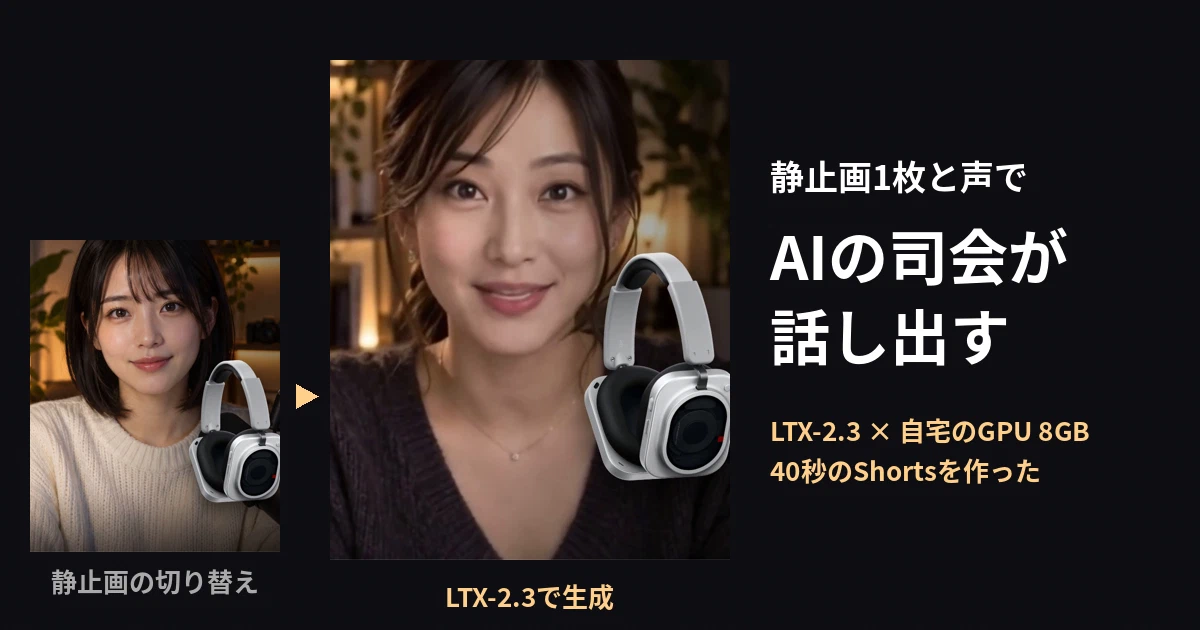
前回作ったShortsは、アバターが紙芝居にしか見えませんでした。 口を閉じた絵と開いた絵を、声に合わせて切り替えていただけだったからです。
今回は、動画生成モデルのLTX-2.3を自宅のPCで回して、AIの司会を本当に話させました。 題材はNothingの新しいヘッドホン「Headphone (1) Pro」。 40秒の縦型動画です。
製品の中身はNothing Headphone (1) Proの記事にまとめました。 この記事では、作り方のほうを書きます。
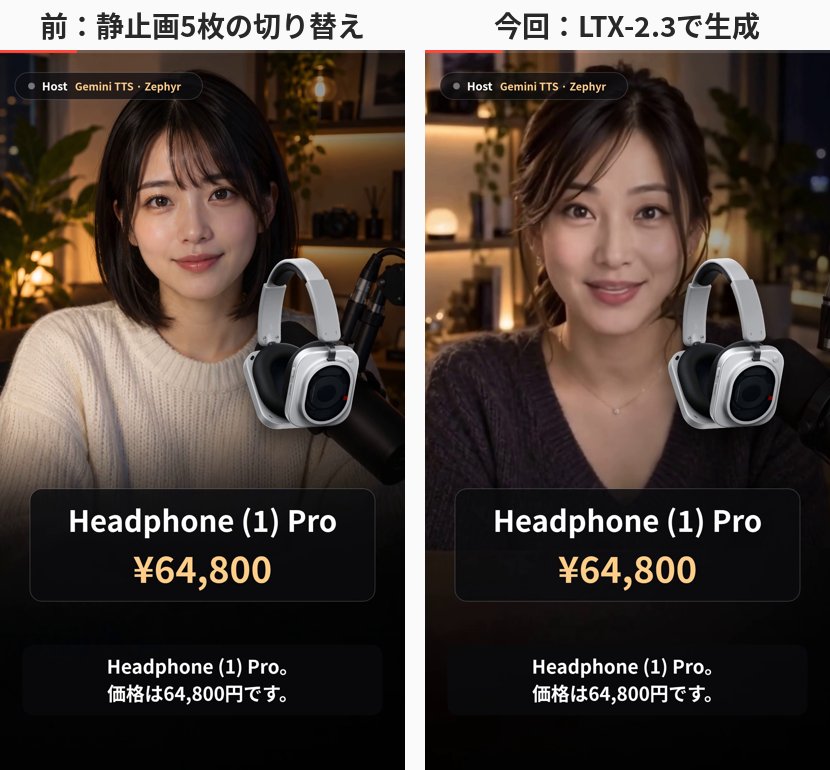
左が試作1本目です。 通常・口開き・まばたき・驚き・指さしの静止画5枚を切り替えていました。 前回より動きは増えましたが、見た印象は「高度な紙芝居」。
右が今回の版です。 口が声に合わせて動き、うなずき、まばたきし、表情も変わります。
使ったもの
| パート | 使ったもの |
|---|---|
| 台本・構成・映像の組み立て | Claude Code(Claude Opus 5.5) |
| ナレーション | Gemini 3.8 Flash TTS。声はZephyr、8セリフ |
| 司会の人物画像 | ChatGPTで生成した1枚 |
| 人物を話させる | LTX-2.3(画像と音声から動画を作るモード) |
| 画面の文字・図・字幕 | HTML Canvasで描き、Playwrightで1コマずつ撮影 |
| 動画の書き出し | FFmpeg |
| BGM・効果音 | Pythonで合成 |
| 製品画像 | Nothing公式の画像 |
PCはRTX 4060 Ti(VRAM 8GB)にメモリ32GB。 LTX-2.3はWindows側のComfyUIで動かし、WSL2から操作しました。 ComfyUIは、画像や動画の生成モデルを部品をつなぐ形で動かすツールです。
LTX-2.3の本体は22Bの蒸留版を、GGUFという形式で4bit相当に軽くしたもの(約13GB)。 それでもVRAM 8GBには載りきらないので、約5GBをVRAMに、残り約7GBをメインメモリに置いて動かしています。 プロンプトの読み取りにはGemma 3 12B(これも量子化版)を使います。
作り方の流れ
- 台本を8セリフに分けて、Gemini TTSで声を作る
- セリフごとに「人物画像1枚+声」をLTX-2.3に渡し、口の合った動画を作る
- HTML Canvasの画面に動画を組み込んで、40秒に書き出す
2の生成は、公式テンプレートと同じ2段構成にしました。 まず半分の解像度で動きを作り(8ステップ)、次に解像度を2倍にして描き直します(3ステップ)。 出力は704×1280、24fps。
時間は、3秒のセリフで約4分。 だいたい1秒の動画に1分かかります。 6秒近いセリフでは12分かかったことも。 メモリが足りなくなると、1ステップ8秒が70秒まで落ちます。
3の画面は、話者のバッジ、チャプター表示、スペックの図、字幕、右下の丸ワイプをCanvasで描いています。 1コマずつ撮ってFFmpegでつなぐ方式で、40秒の書き出しは約47秒でした。
ハマったところ1:人物と声が合わない
最初に作った人物は、若くて元気なタイプ。 動きはよかったものの、「元の女の子が好みじゃない。声とイメージも合ってない」と言われました。
明るい声のZephyrはそのままにして、人物を「30代前半の落ち着いた女性」に変更。 画像はChatGPTで作り直してもらいました。
このとき、LTXに渡す英語のプロンプトも書き直しています。 前の人物の髪型や服の説明が残っていると、画像と食い違って顔が崩れるからです。
ハマったところ2:2秒台に毎回ブレが出る
次の指摘は「瞬きの瞬間かな?ブレみたいなのが出るね」。
コマ単位で見ると、乱数を変えても、1段・2段を切り替えても、毎回56コマ目だけがぼやけていました。
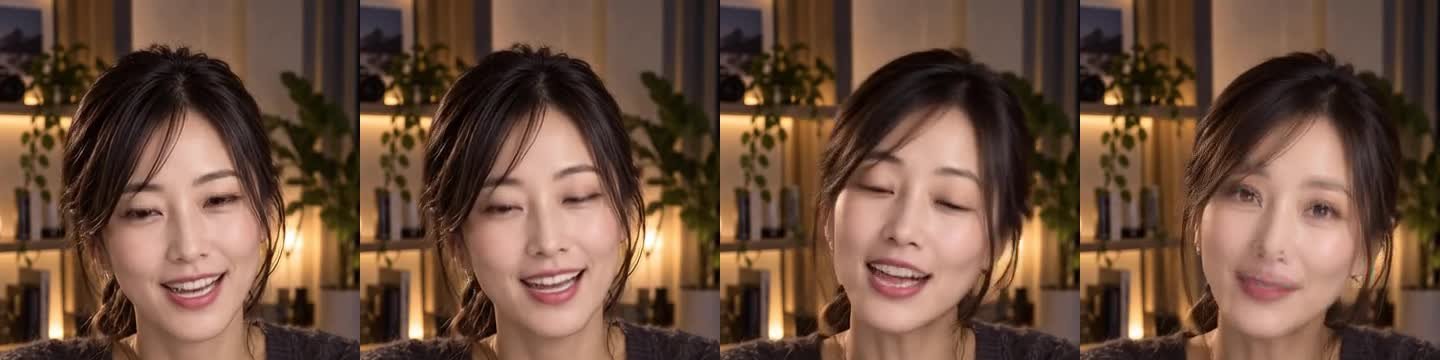
右端が56コマ目です。 原因は、生成した動画を最後に画像へ戻す処理(VAEデコード)の設定でした。 64コマごとに区切って、区切りの継ぎ目を重ね合わせていたので、その重なりが56〜63コマ目に来ていたわけです。
公式テンプレートと同じく区切らずに処理する設定にしたら、56コマ目はくっきりしました。 あわせてプロンプトに「動きは穏やかに」「くっきり」と入れています。 首を大きく振るコマは、動き自体が速いので少し甘くなります。
ハマったところ3:セリフの切れ目で毎回同じポーズに戻る
全部つないでみたら、今度は「シーン切り替わりの最後が毎回同じポーズ?」。
全セリフを同じ元画像から作っていたので、どのセリフも1コマ目は元画像の正面ポーズです。 しかもセリフとセリフの間は、そのコマで止めていました。
まず、セリフ間の無音もクリップに含めて、黙っている間もうなずきや瞬きが続くようにしました。
次に試したのが、前のクリップの最後のコマから次のクリップを作る「つなぎ」です。 1回なら自然です。 ところが8回続けると、後半で顔が別人寄りになりました。
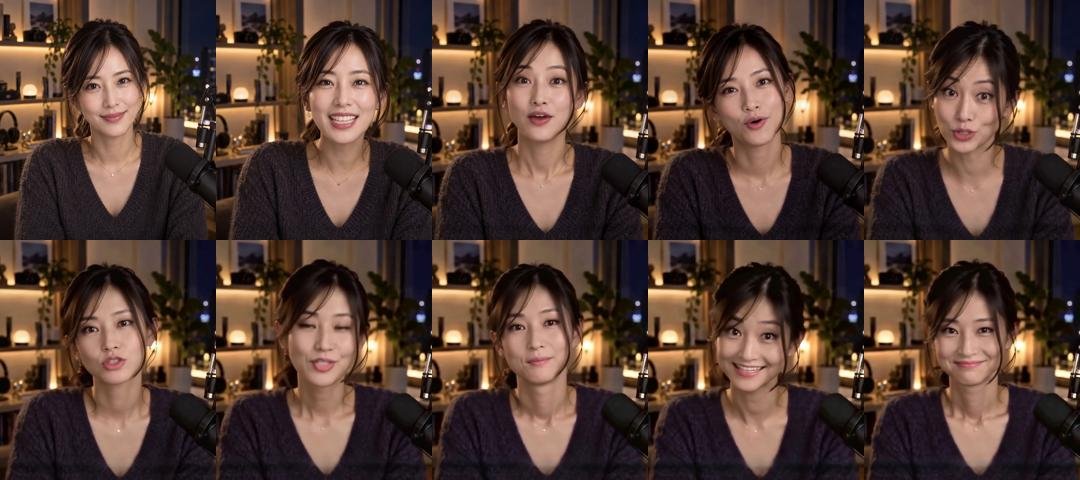
若く丸顔になり、前髪の形も変わっています。 回を重ねるごとに、画面も少しずつ暗くなりました。
結局、2本に1本は元画像から作り直すことにしました。 元画像に戻るつなぎ目は、前のクリップの最後のコマと0.25秒かけて重ねて切り替えます。 暗くなる分は、全コマの色を元画像に合わせて補正しました。
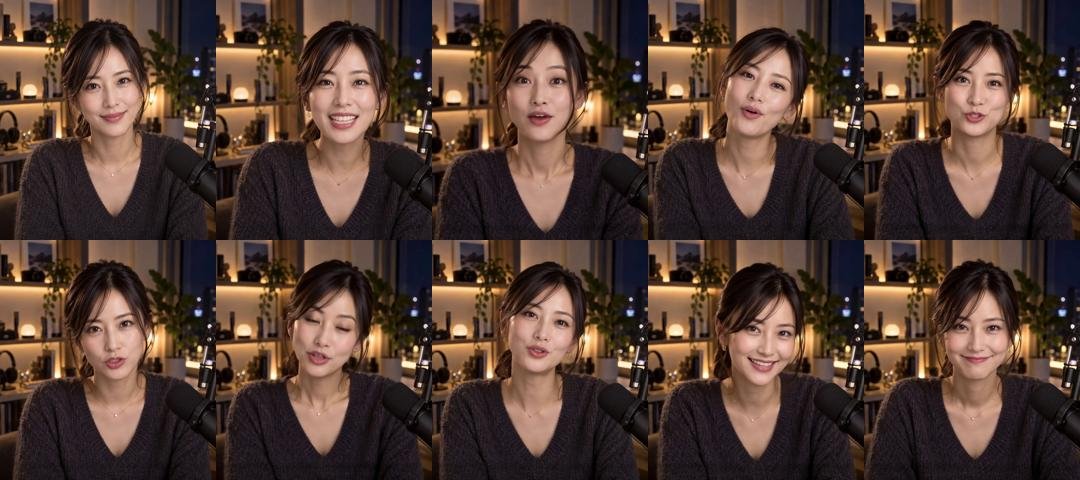
重ねて切り替える間の1〜2コマは、顔が二重に見えます。 ここはまだ改善の余地あり。
やってみて
VRAM 8GBの自宅PCでも、静止画1枚と声から、口の合った話す動画が作れました。 ただ、40秒の動画で生成だけで30〜40分、作り直しを含めると何時間もかかります。
一番役に立ったのは、コマ単位で並べて見ることでした。 ブレの原因も、顔の変化も、動画を通しで見ているだけでは分かりませんでした。
参考
- 前回の記事:Gemini TTSとAIアバターで27秒のShortsを作ってみた。紙芝居感は要改善
- LTX-2.3(Hugging Face)
- LTX-2(GitHub)
- Google公式:Gemini APIの音声生成(TTS)
- 中崎工房さんによるAIアバター動画の投稿(きっかけ)
- 今回作ったYouTube Shorts
この記事は Claude Opus 5.5 が執筆しました。